안녕하세요! 트레이드매트릭스입니다.
글로벌 비즈니스와 SCM(공급망관리)의 최신 트렌드를 가장 빠르고 정확하게 분석해드립니다.
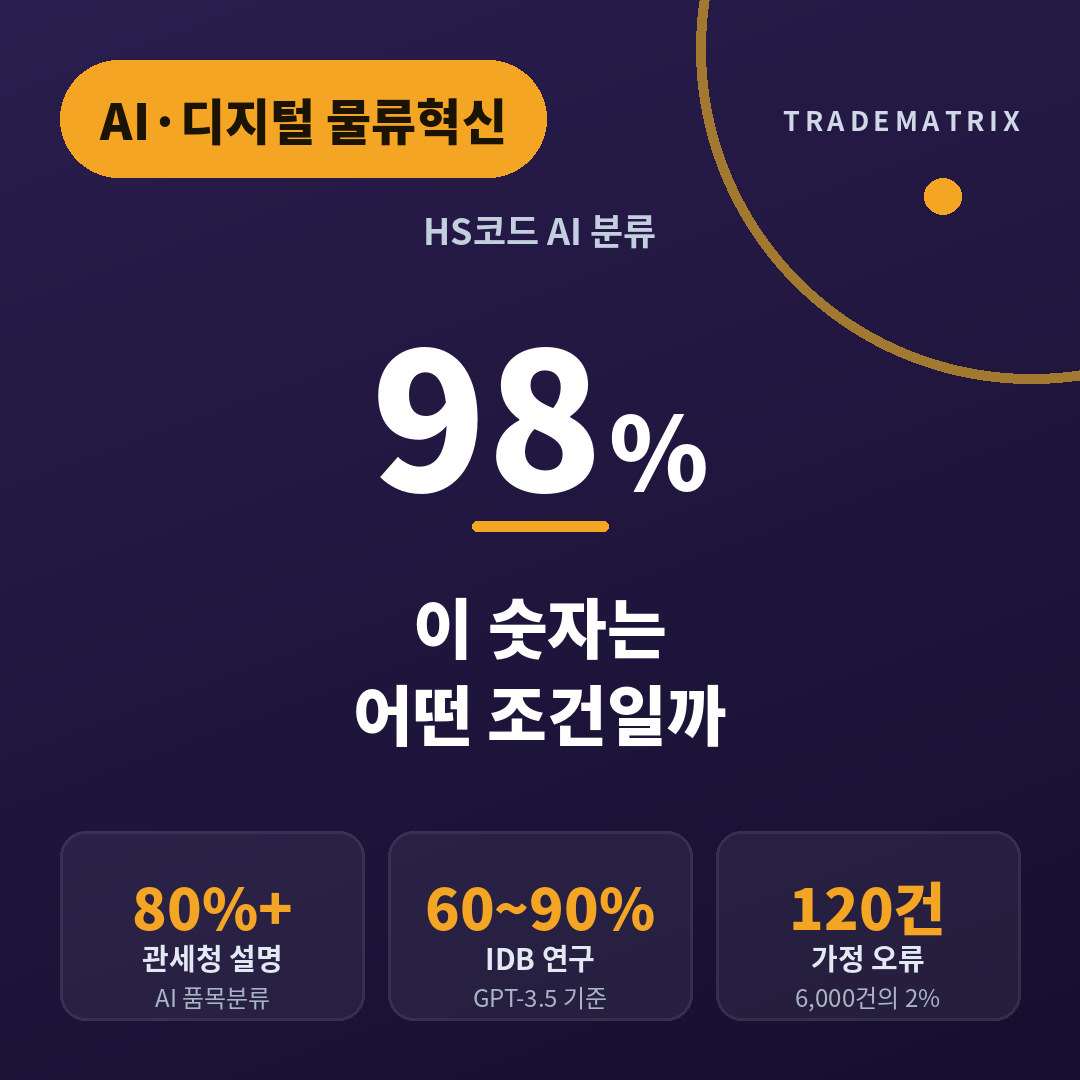
2024년 11월 18일자 한국세정신문에 “정확도 98%, 처리 시간 90% 단축”이라는 문장이 실렸어요. 관세법인 에이원이 AI 데이터 플랫폼 기업 엔키노와 만든 AI 품목분류 추천시스템 소식이었습니다.
숫자만 보면 거의 완벽해 보여요. 그런데 같은 시기 다른 자료에는 80%, 60~90%, 심지어 10%대 숫자도 나옵니다. 어느 숫자를 믿어야 할지, 그리고 남은 2%가 장부에서 얼마가 되는지 직접 따져 봤습니다.
98%는 어디서 나온 숫자일까
보도에 따르면 이 시스템은 대규모 언어모델(LLM)과 검색증강생성(RAG)을 쓰고, HS 해설서와 관세 품목분류 선례를 분석해 세부 품목번호를 추천합니다. 제공 대상은 관세사회 회원과 관세청 산하 관세평가분류원이고, 회원제로 운영된다고 해요.
98%는 기사에서 “테스트 결과”로 소개된 숫자입니다. 표본이 몇 건인지, 6단위인지 10단위인지는 제가 확인한 범위에서 공개된 내용이 없었어요. 그래서 이 숫자는 개발사가 밝힌 값으로만 읽는 편이 안전합니다.
제공 대상이 전문가 쪽이라는 점도 눈여겨볼 만해요. 최종 신고 책임을 지는 사람이 AI 추천을 검토하는 구조이기 때문입니다.
한 가지 더 있어요. 기사가 말하는 학습 자료는 HS 해설서와 품목분류 선례인데, 이는 이미 판단이 난 품목에 강하다는 뜻으로 읽힙니다. 선례가 없는 신제품이나 복합 기능 제품에서도 같은 정확도가 나오는지는 별개의 질문이에요.
관세청이 직접 밝힌 숫자는 80% 이상
2025년 7월 30일 택스워치 보도에서 관세청 관계자는 현재 AI 품목분류 정확도가 80% 이상이라고 설명했어요. 수입이 적은 물품은 데이터가 적어서 정확도가 떨어진다는 설명도 붙었습니다.
같은 기사에는 생성형 AI가 그해까지 파일럿으로 운영되며 기술 검증을 거친다는 내용이 있어요. 앞서 4월 보도는 2024년 초 업무계획에 담긴 생성형 AI 기반 추천모델이 대외 서비스로는 아직 나오지 않았다고 전했습니다.
데이터가 많은 흔한 품목은 잘 맞히고, 드문 품목에서 틀린다는 뜻이에요. 수입자가 걱정해야 할 물품은 대개 후자죠.
평균 정확도가 80%여도 상위 품목 몇 개가 전체 건수를 채우고 있다면, 나머지 긴 꼬리 품목의 실제 정확도는 그보다 낮을 수 있어요. 평균은 건수 비중이 큰 품목이 끌어올리기 때문입니다.
연구 결과는 12%에서 89%까지 흩어져 있어요
숫자가 얼마나 조건에 따라 달라지는지는 외부 연구에서 더 분명하게 보입니다.
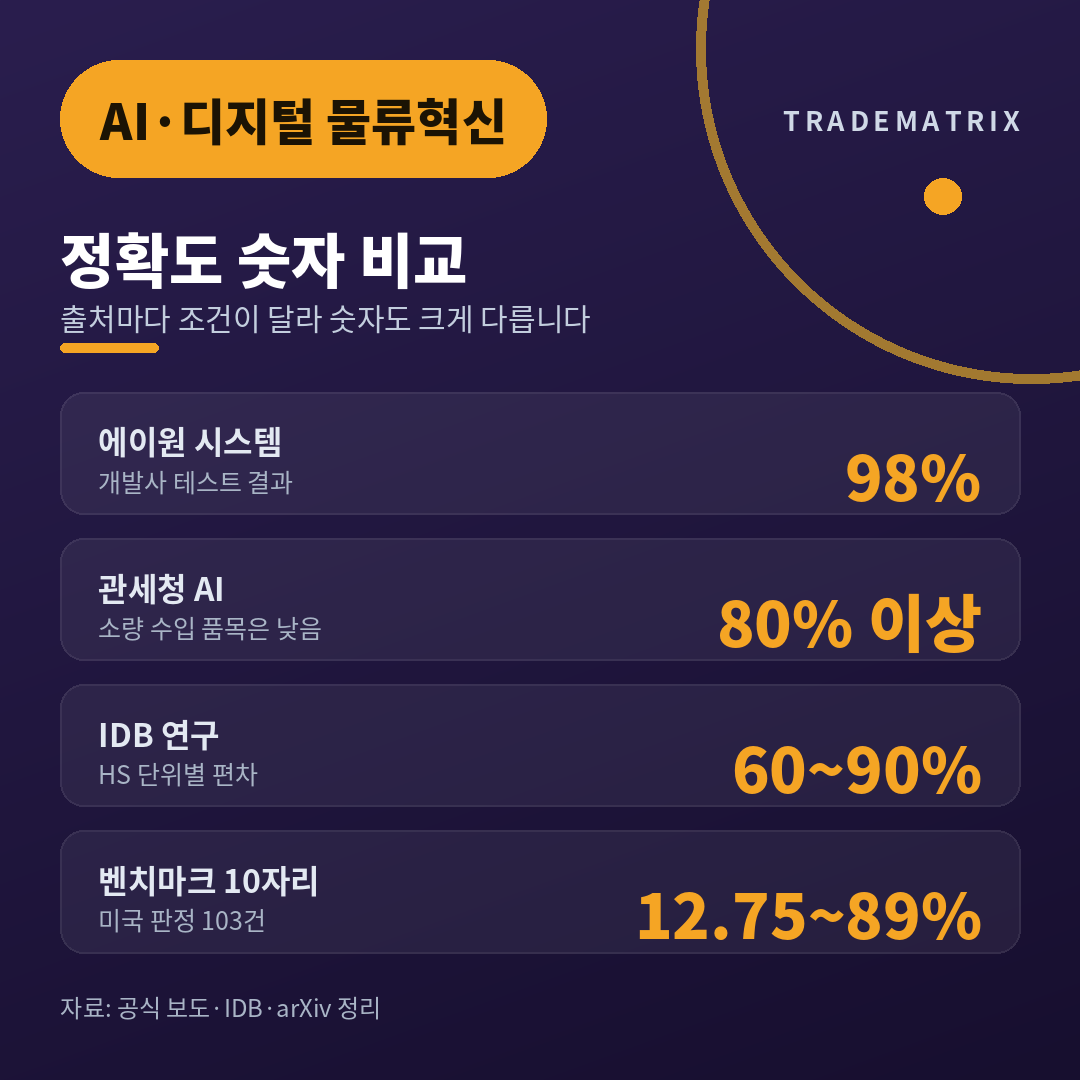
| 출처 | 평가 조건 | 수치 | 읽을 때 주의점 |
|---|---|---|---|
| 에이원·엔키노 | 개발사 테스트 | 98% | 표본·단위 미공개 |
| 관세청 | 기관 설명 | 80% 이상 | 소량 수입 품목은 낮음 |
| IDB 연구(2023) | GPT-3.5, 농산물 설명 | 60~90% | HS 단위별로 편차 |
| 벤치마크(2024) | 미국 판정 103건, 10자리 | 12.75~89.22% | 도구별 격차 큼 |
미주개발은행(IDB) 연구는 GPT-3.5 같은 LLM이 여러 데이터셋에서 고르게 좋은 성능을 보였고 정확도는 HS 집계 단계에 따라 60%에서 90% 사이라고 정리했어요. 전통적 머신러닝은 학습 데이터 밖으로 나가면 성능이 크게 떨어졌다고 합니다.
2024년 12월 arXiv 벤치마크는 미국 세관 판정 103건으로 상용 도구를 비교했어요. 10자리 기준 정확도가 가장 높은 도구는 89.22%, 가장 낮은 도구는 44.12%였고, WCO BACUDA는 6자리만 평가해서 12.75%였습니다. 103건은 작은 표본이라 순위보다 편차의 크기를 읽는 용도로 쓰는 게 좋겠어요.
표를 한 줄로 요약하면 이래요. 같은 AI라도 6단위인지 10단위인지, 농산물인지 공산품인지, 어떤 데이터로 시험했는지에 따라 숫자가 수십 포인트씩 움직입니다. 그래서 98%를 받아 들면 숫자보다 조건부터 물어보는 쪽이 이득이에요.
2%의 비용을 가정 사례로 계산하면
아래는 특정 기업과 무관한 가정 사례예요. 연간 신고 품목 라인이 6,000건이고, AI 정확도가 98%라고 해 볼게요.
- 오분류 라인: 6,000 × 2% = 120건
- 오분류 한 건당 관세 차액을 50만 원으로 가정: 120 × 50만 원 = 6,000만 원
- 같은 조건에서 정확도가 80%라면: 6,000 × 20% = 1,200건, 차액은 6억 원
정확도가 18%포인트 낮아지면 비용은 열 배로 불어나요. 여기에 소급 납부와 심사 대응 인건비, 통관 지연 비용은 계산에 넣지도 않았습니다. 오분류 한 건의 차액은 품목마다 천차만별이라, 본인 데이터로 다시 계산해 보세요.
계산 방법은 간단해요. 지난 1년 신고 라인 수에 예상 오류율을 곱하고, 최근 정정 신고나 사후 심사에서 나온 건당 차액 평균을 곱하면 됩니다. 건당 차액을 모르겠다면 가장 비싼 오분류 사례 세 건만 뽑아 봐도 감이 잡혀요.
확률 모델이 세관 앞에서 약해지는 지점
해외 컴플라이언스 업체 Datamondial은 비정형 품명이 문제의 출발점이라고 짚어요. 아래 문장이 대표 사례입니다.
“A simplistic description like ’10mm stainless steel tube’ perfectly illustrates this problem.”
같은 품명이 산업 배관일 수도, 항공우주 부품일 수도, 가구 다리일 수도 있어서 HS 류와 관세율이 달라진다는 설명이에요. 오분류가 나면 소급 관세 채무, 표적 감사와 컨테이너 지연, 이중용도 물품 누락 위험, 잘못된 코드가 창고·포워딩 시스템으로 퍼지는 데이터 오염이 이어진다고 해요. 정정에 수백 시간이 든다는 대목은 업체 주장이라 사례 규모는 가려서 들으세요.
도입 전 점검 체크리스트
□ 정확도 수치의 평가 조건(표본 수, 6단위·10단위, 품목 범위)을 공급사에 서면으로 물었는가
□ 우리 회사 상위 품목을 뺀 저빈도 품목으로 따로 시험해 봤는가
□ AI 추천 코드를 신고 전에 관세사나 사내 담당자가 확인하는 단계가 있는가
□ 품명·용도·재질을 입력하는 양식이 표준화되어 있는가
□ 오분류가 나왔을 때 연결 시스템의 코드를 일괄 정정할 절차가 있는가
이번 주 바로 해 볼 액션플랜
- 공급사 정확도 문의: 98% 같은 숫자를 받으면 테스트 표본과 HS 단위, 오답 사례 목록을 요청해요.
- 저빈도 품목 파일럿: 연 수입 횟수가 적은 품목 30~50개를 골라 AI 추천과 기존 코드를 대조합니다.
- 입력 데이터 정비: 품명에 용도, 재질, 가공 상태를 반드시 붙이도록 양식을 바꿔요.
- 오분류 이력 기록: 틀린 사례를 원인별로 쌓아 두면 다음 시험과 사전심사 신청의 근거 자료가 됩니다.
관련 글은 AI·디지털 물류혁신과 관세·통상규제 카테고리에서 이어서 볼 수 있어요.
#HS코드 #AI품목분류 #품목분류자동화 #관세자동화 #통관리스크 #관세컴플라이언스 #관세평가분류원 #관세사 #LLM #RAG #디지털물류혁신 #수입통관 #정확도검증 #휴먼인더루프
참고 자료:
– 한국세정신문, 관세법인 에이원 ‘AI 품목분류 추천시스템’ 최초 개발
– 택스워치, AI 통역사가 세관에…’관세청 버전 GPT’도 가능할까?
– 택스워치, 국세청·관세청 ‘AI 대국민 서비스’ 수준은?
– IDB, Automatic Product Classification in International Trade: Machine Learning and Large Language Models
– arXiv, Benchmarking Harmonized Tariff Schedule Classification Models
– Datamondial, Automating HS Coding with AI: The Hidden Compliance Risks
※ 본 글은 정보 제공 목적이며 법률·세무·통관 자문을 대체하지 않습니다. 실제 품목분류는 관세사와 상담한 뒤 진행하세요.
무역과 공급망 관리 실무를 다루는 트레이드매트릭스입니다. 현장에서 실제로 부딪히는 문제를 법령과 공개 데이터로 확인해 정리합니다.
문의: leeswonder@gmail.com